
Смена Модели индексации документов#
Эта инструкция помогает сменить Модель, которая создает векторы для поиска по документам. При смене Модели или размерности Sherpa AI Server очищает старые векторы и пересчитывает их по сохраненным текстовым фрагментам. Распознанный текст сохраняется. Файлы без сохраненных фрагментов читаются заново. На время переключения поиск по содержимому может быть недоступен, а до завершения обработки файлов результаты могут быть неполными. Необходимо запланировать переключение на подходящее время.
Перед началом#
Перед изменением Модели необходимо проверить следующие условия:
- Для назначения стандартной Модели нужны права
ai_models:read,ai_models:update,api:read,api:updateиdocuments:read. Для изменения параметров на экране Документы требуетсяdocuments:update. Если Модель или ее Экземпляр еще не созданы, дополнительно требуетсяai_models:create. - Необходимо узнать фактическую размерность вектора новой Модели. Необходимо указать число, которое она возвращает: целое от 32 до 2000. При переходе с 2.5.0 на 2.5.1 необходимо подготовить индексы 384 и 1024. Если текущая версия ниже 2.5.0, сначала необходимо согласовать путь обновления с сопровождением. Для другой размерности администратор должен заранее подготовить поисковый индекс.
- У Модели должна быть включена поддержка "Индексация" и должен быть ровно один активный Экземпляр. Несколько Экземпляров одной Модели могут возвращать несовместимые векторы.
- Нельзя менять адрес или путь активного экземпляра текущей Модели индексации, чтобы направить его на другой источник векторов: система отклонит такое изменение. Можно создать отдельную Модель с новым экземпляром и затем необходимо назначить ее стандартной для индексации в карточке.
- Фрагменты, добавленные только через API, пересчитываются по своему сохраненному тексту. Если одновременно меняете размер или перекрытие чанков, сначала необходимо сохранить такие фрагменты вне системы: повторную нарезку без исходного файла выполнить нельзя.
Пример: BGE-M3 через vLLM#
На сервере с GPU необходимо запустить отдельный экземпляр vLLM для Модели индексации. Пример для vLLM 0.27.1 и Модели BAAI/bge-m3 (нужны установленный vLLM и доступ к файлам Модели):
vllm serve BAAI/bge-m3 --runner pooling --pooler-config.task embed \
  --hf-overrides '{"architectures":["BgeM3EmbeddingModel"]}' \
  --host 0.0.0.0 --port 8001
На сервере vLLM необходимо проверить, что Модель возвращает вектор из 1024 чисел (для команды нужен jq):
curl -fsS http://127.0.0.1:8001/v1/embeddings \
  -H 'Content-Type: application/json' \
  -d '{"model":"BAAI/bge-m3","input":["test"]}' \
  | jq '.data[0].embedding | length'
На экране Модели необходимо создать Модель с поддержкой "Индексация" и один активный локальный Экземпляр. В Экземпляре необходимо указать путь BAAI/bge-m3, порт 8001 и адрес vLLM, доступный из контейнера Sherpa AI Server. Если vLLM работает на другом сервере, используется его сетевое имя или IP. Адрес 127.0.0.1 внутри контейнера Sherpa указывает на сам контейнер. Дополнительный путь API необходимо оставить пустым.
До стандартного назначения необходимо настроить формат API эмбеддингов. Поле "Формат API эмбеддингов" доступно у локального Экземпляра Модели с поддержкой "Индексация". Для изменения существующего Экземпляра требуется право ai_models:update.
- На экране Модели необходимо выбрать нужную Модель и открыть редактирование ее локального экземпляра.
- В поле «Формат API эмбеддингов» необходимо выбрать «OpenAI (/v1/embeddings)» и нажать на кнопку «OK».
- Необходимо снова открыть экземпляр и убедиться, что выбранный формат сохранился. Последующее редактирование экземпляра сохраняет этот формат и дополнительные параметры подключения.
Значение «Автоматически (по типу экземпляра)» сохраняет прежний выбор API по типу экземпляра. Варианты «vLLM (/v2/embed)» и «API v2 (/v2/embed)» используют /v2/embed, а «Cohere (/v2/embed, input_type)» дополнительно передает input_type. Для BGE-M3 в этом примере требуется OpenAI.
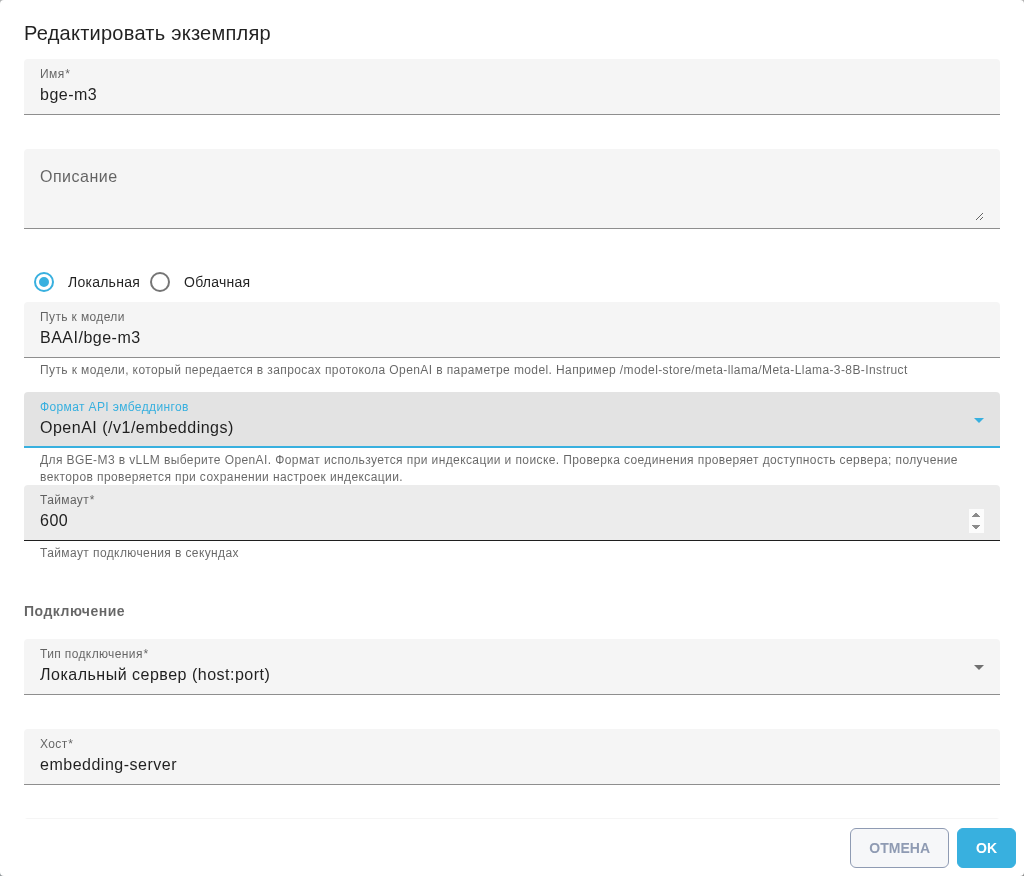
Окно «Редактировать экземпляр»: для BGE-M3 выбран формат OpenAI.
Если поля «Формат API эмбеддингов» нет, установленная версия еще не поддерживает выбор через форму. Необходимо выполнить GET /api/v1/models/{model_guid}/instances/{instance_guid}, получить весь объект data.connection_params, добавить в него "embed_format": "openai" и передать полный обновленный объект в PATCH по тому же адресу как {"connection_params": {…}}. При PATCH объект заменяется целиком, поэтому необходимо сохранить все поля подключения и авторизации. Повторный GET должен подтвердить значение openai. В версии без этого поля нельзя сохранять экземпляр через форму: она удалит настройку.
Формат OpenAI направляет запросы Sherpa к /v1/embeddings. Проверка соединения в форме проверяет доступность сервера. Фактическую выдачу векторов Sherpa проверит при сохранении настроек индексации. Затем необходимо выбрать новую Модель и размерность 1024 по шагам ниже.
Работа без локальной Модели Embed#
Если стандартной для индексации назначена внешняя Модель, например через vLLM, администратор сервера может отключить загрузку локальной Модели внутри aiserver-embed. Сам контейнер нужен для обработки документов, OCR, текстовых фрагментов, BM25, хранения векторов и поиска. Адрес EMBED_MODEL_API_BASE_URL должен указывать на этот сервис Sherpa, а не на обычный vLLM.
- Сначала необходимо настроить внешнюю Модель и назначить ее стандартной для индексации в карточке на экране Модели. Затем необходимо проверить индексацию и поиск по одному тестовому Документу.
- В файле
.envустановки необходимо указать:
EMBED_LOCAL_MODEL_ENABLED=false
- Из каталога установки необходимо пересоздать только контейнер Embed. Для стандартного файла
docker-compose.yml:
docker compose up -d --no-deps --force-recreate aiserver-embed
Если установка использует другой Compose-файл или имя проекта, необходимо указать те же параметры -f и -p, с которыми она запущена. Пересоздание временно прерывает обработку документов и поиск. После запуска необходимо повторить проверку тестового документа. В логах появится Local embedding model disabled by EMBED_LOCAL_MODEL_ENABLED.
При false локальная Модель не загружается и не скачивается, даже если веса уже есть. Сохраненные веса остаются на диске. Переменная EMBED_DOWNLOAD_MODEL=false запрещает только скачивание отсутствующих весов и сама по себе не отключает загрузку сохраненной Модели. Локальные методы /v1/embeddings и /v2/embed возвращают HTTP 503 model_not_loaded. Векторы должны поступать от выбранной внешней Модели.
По умолчанию EMBED_LOCAL_MODEL_ENABLED=true. Чтобы вернуть локальную Модель, необходимо установить true и пересоздать контейнер. Если весов нет, для их скачивания также потребуется EMBED_DOWNLOAD_MODEL=true.
Порядок переключения#
Для переключения Модели индексации необходимо выполнить следующие действия:
На экране Модели необходимо проверить поддержку "Индексация" у нужной Модели и доступность ее единственного активного Экземпляра. Если карточки нет, необходимо создать Модель и Экземпляр либо обратиться к администратору.
В карточке новой Модели необходимо отметить "По умолчанию" в строке "Индексация". Во всплывающем окне "Стандартная модель индексации" необходимо указать фактическую размерность. Изменение только размерности в настройках Документов не выбирает другую Модель.

Всплывающее окно "Стандартная модель индексации": для BGE-M3 указана размерность 1024
Для проверки и начала перехода необходимо нажать на кнопку "Подтвердить переключение и переиндексацию". Сервер проверит Модель, ее размерность и поисковый индекс. После успешной проверки сохраняются Модель и размерность, старые векторы очищаются, Документы с автоматической индексацией ставятся в очередь. Сохраненный текст остается. Повторное распознавание требуется только файлам без сохраненного текста. Исходные файлы сохраняются. Отдельно нажимать на кнопку "Удалить все векторы и переиндексировать" не требуется. Смена Модели при той же размерности также запускает переход.
Необходимо дождаться обработки документов: Ожидает обработки → В обработке → Готов. Если файл получил статус Ожидает ручной индексации, можно открыть его и можно нажать на кнопку "Переиндексировать", затем необходимо дождаться статуса Готов. Файлы со статусом Не индексируется не индексируются. Образцы ответов Ассистентов сервер переиндексирует автоматически.
Необходимо проверить поиск по известному документу и необходимо убедиться, что нужные файлы получили статус Готов. Если у файла статус Ошибка, можно открыть причину и необходимо устранить ее. После этого можно нажать на кнопку "Переиндексировать" у этого файла. Для повторной обработки всех файлов отдельно можно использовать "Удалить все векторы и переиндексировать".
Статус перехода ready означает, что переключение настроек завершилось. Он не означает, что все файлы получили статус Готов. Если в ответе API показано queued_files, это число файлов, поставленных в очередь, а не число уже обработанных файлов. Необходимо проверять статус документов и поиск после завершения их индексации.
Если стандартная Модель индексации не назначена, в настройках Документов показано "Не назначена". Векторные операции возвращают 404 model_not_found, без переключения на параметры .env. Снятие стандартного назначения в карточке сохраняет файлы и векторы, но индексация и векторный поиск недоступны до нового назначения. Недоступный активный Экземпляр возвращает 503 model_unavailable.
Примеры#
Возможны следующие варианты переключения:
- 384 → 1024. Необходимо выбрать новую Модель с вектором размерности 1024, необходимо указать 1024 и необходимо нажать на кнопку "Подтвердить переключение и переиндексацию". Необходимо дождаться повторной индексации файлов и необходимо проверить поиск.
- 1024 → 384. Необходимо выбрать Модель с вектором размерности 384, необходимо указать 384 и необходимо выполнить те же действия.
- 384 → 384, другая Модель. Необходимо выбрать другую Модель, необходимо оставить 384 и необходимо нажать на кнопку "Подтвердить переключение и переиндексацию". Смена Модели запускает повторную индексацию, хотя размерность не изменилась.
Если меняется нарезка текста#
При изменении полей "Размер чанка" или "Перекрытие чанков" рядом с полем появляется предупреждение. Для чтения пояснения необходимо навести на него указатель или перейти к нему клавишей Tab. После нажатия на кнопку "Сохранить" прежние текстовые фрагменты удаляются, файлы читаются заново и нарезаются по новым параметрам. Для сканов повторное распознавание может значительно увеличить время переиндексации. Если вместе с нарезкой меняется Модель или размерность, новые векторы создаются после повторного чтения файлов.
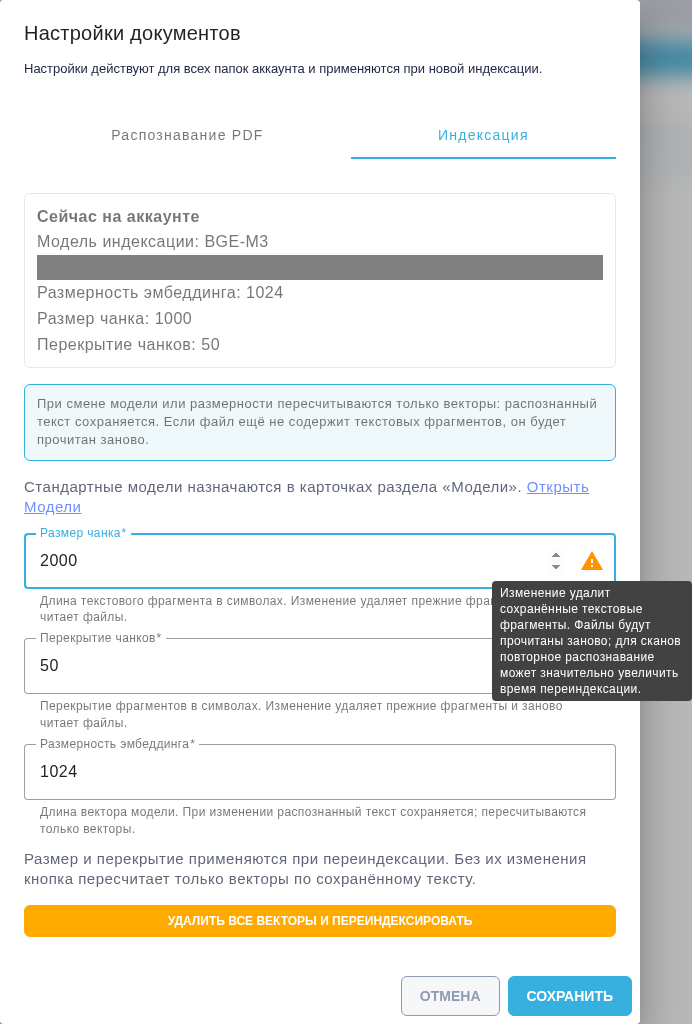
Всплывающее окно "Настройки документов", вкладка "Индексация": предупреждение об изменении размера чанка
Если размер и перекрытие чанков не менялись, кнопка "Удалить все векторы и переиндексировать" пересчитывает векторы по сохраненному тексту. Файлы без сохраненных фрагментов читаются заново. Отдельной команды повторно распознать все файлы нет.
Если переключение отклонено или прервалось#
Если предварительная проверка не прошла из-за недоступной Модели, неверной размерности или неподготовленного индекса, необходимо устранить причину и повторить сохранение. Если одновременно изменились размер или перекрытие чанков и переход отклонен из-за фрагментов, добавленных только через API, необходимо сохранить их текст и метаданные вне системы. Затем необходимо удалить эти фрагменты или содержащий их файл и необходимо повторить изменение нарезки. При смене только Модели или размерности API-фрагменты сохраняются и получают новые векторы.
Кнопка "Продолжить переход", блокировка полей и счетчики оставшейся обработки доступны начиная с версии 2.5.4. В версии 2.5.3 для продолжения используется кнопка "Сохранить".
На рабочем сервере повтор перехода, переиндексацию и удаление данных необходимо заранее согласовать с ответственным администратором.
При незавершенном переходе необходимо выполнить следующие действия. Нужны права documents:update и ai_models:read.
- Необходимо закрыть окно настроек, затем на экране Документы нажать на кнопку "Обработка документов" и открыть вкладку "Индексация".
- Необходимо оставить загруженные с сервера Модель, размерность, размер чанка и перекрытие. Это значения начатого перехода. Они могут отличаться от значений до первой попытки. В новом интерфейсе эти поля и параметры распознавания заблокированы. Блок "Сейчас на аккаунте" показывает сохраненную конфигурацию. Счетчики показывают оставшиеся файлы и образцы ответов Ассистентов. Они обновляются после повторного открытия окна или ошибки.
- После устранения показанной причины ошибки необходимо нажать на кнопку "Продолжить переход". В версии 2.5.3 необходимо нажать на кнопку "Сохранить" без изменения всех четырех параметров. Сервер продолжит оставшуюся обработку. Если повторная попытка снова завершилась ошибкой, необходимо передать администратору время ошибки и идентификатор файла.
- После завершения перехода необходимо дождаться статуса "Готов" у нужных документов и проверить поиск по известному фрагменту. Состояние
readyозначает завершение перехода настроек, а не индексации всех файлов. После восстановления поиска запрос в Чат необходимо отправить повторно. - Новые размер и перекрытие чанков необходимо задать отдельным сохранением после завершения перехода.
Пример: на Аккаунте начат переход с Моделью BGE-embed, размерностью 1024, размером чанка 4000 и перекрытием 200. Для завершения необходимо нажать на кнопку "Продолжить переход" во всплывающем окне "Настройки документов" на вкладке "Индексация". Эти значения остаются без изменений. Новые 1000 и 50 задаются отдельным сохранением после завершения.
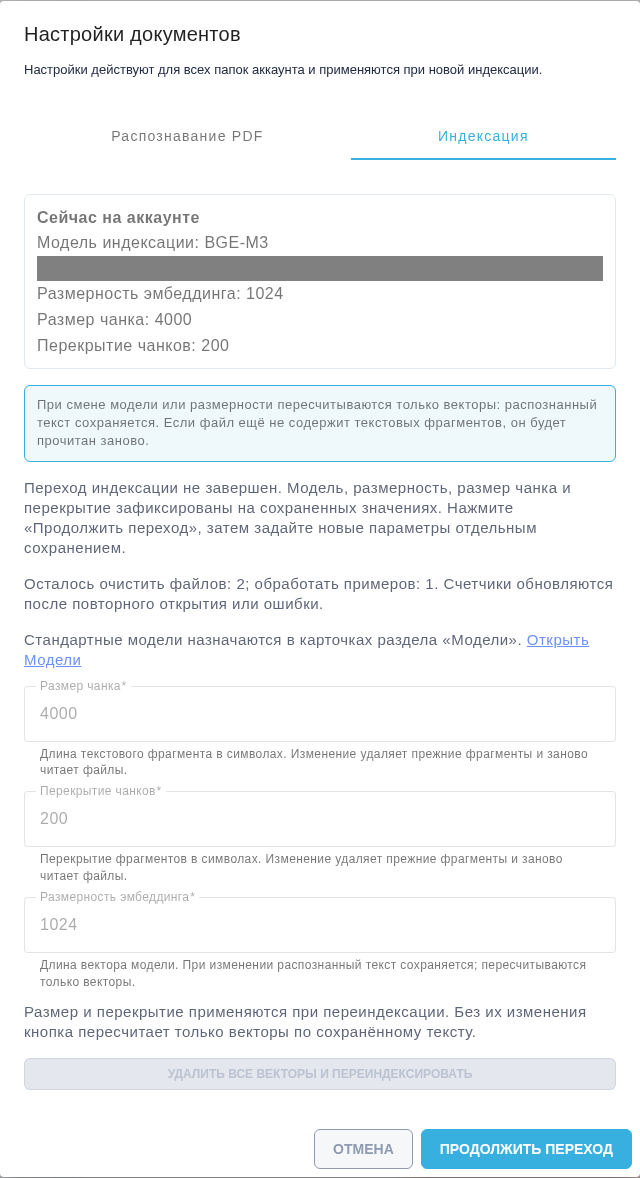
Вкладка "Индексация" во всплывающем окне "Настройки документов". Интерфейс на русском языке.
В новом интерфейсе настройки распознавания и индексации сохраняются отдельно. Если требуется изменить обе группы, необходимо сначала сохранить распознавание без изменений индексации. Затем необходимо открыть окно заново и сохранить индексацию. При незавершенном переходе распознавание недоступно для изменения. Продолжение перехода не перезаписывает OCR и стандартную Модель распознавания. Если отдельное сохранение OCR завершилось частично, окно повторно загрузит сохраненные значения. Их необходимо проверить перед повтором. Стандартную Модель распознавания необходимо проверить на экране Модели. В версии 2.5.3 после ошибки параметры OCR могли сохраниться отдельно.
Начиная с версии 2.5.4 повторная попытка пропускает завершенные файлы и образцы ответов. Если пересчет сохраненных фрагментов файла с ручной индексацией прервался, файл остается среди незавершенных до успешного повтора. Оригиналы файлов сохраняются. Нельзя удалять их или вручную снимать состояние pending только ради восстановления поиска.
Администратору необходимо различать таймаут ожидания, ответ сервера с ошибкой, недоступность соединения и ошибку базы данных. В обновлении время ожидания удаления векторов задается отдельно: EMBED_CLEANUP_TIMEOUT_SECONDS, по умолчанию 120 секунд, допустимы целые от 1 до 3600. Неверное значение заменяется значением по умолчанию. Этот параметр не меняет таймауты запросов к Моделям. Прокси может прервать общий запрос раньше. После устранения причины необходимо повторить переход с той же конфигурацией. Сервер эмбеддингов может закончить удаление уже после таймаута, поэтому само сообщение об ошибке не доказывает, что данные остались без изменений.
Проверка пути Модели и причины ошибки#
Для проверки подключения необходимо открыть единственный активный экземпляр выбранной Модели индексации на экране Модели. В поле "Путь к модели" требуется указать идентификатор сервера эмбеддингов, например BAAI/bge-m3. Для облачного экземпляра идентификатор может быть задан параметром model подключения. Если заполнены оба значения, используется "Путь к модели". Идентификатор можно проверить через /v1/models выбранного сервера. Пустое поле не следует использовать для выбора чат-Модели.
Пустой путь отклоняется до запроса к серверу. Ссылка "Открыть Модели" в настройках Документов ведет к карточкам, в которых задаются стандартное назначение и параметры Экземпляра. Если сервер отклонил идентификатор или вернул другую размерность, сообщение указывает выбранную Модель и параметры, которые необходимо проверить.
Пример: очистка файла "document.pdf" прервалась из-за недоступности сервера эмбеддингов. Сообщение показывает имя файла и причину. Администратору необходимо восстановить соединение с сервером и повторить переход с сохраненными параметрами. Начиная с версии 2.5.4 уже завершенные файлы повторно не очищаются.
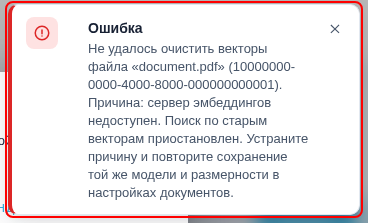
Ошибка очистки векторов. Интерфейс на русском языке.
Если Чат не может искать документы#
Запрос Чата сохраняется при известном конфликте поиска. Вместо ответа Модели появляется пояснение о незавершенном переходе, несовпадении размерности или Модели поискового вектора. Ответ также может сообщать, что Модель индексации не смогла создать поисковый вектор. Он указывает Модель и размерность из настроек. Перезагрузка страницы не запускает отказавший запрос автоматически.
- Администратору необходимо проверить вкладку "Индексация" во всплывающем окне "Настройки документов". Если очистка не завершена, требуется устранить показанную причину и продолжить переход с теми же Моделью, размерностью, размером чанка и перекрытием.
- После завершения перехода необходимо дождаться готовности нужных документов и проверить поиск по известному фрагменту. Состояние
readyне подтверждает готовность всех файлов. - После восстановления индексации Пользователю необходимо отправить запрос в Чат еще раз. При несовпадении размерности или источника векторов требуется проверить выбранную Модель и переиндексировать документы. При недоступности Модели необходимо проверить подключение и путь ее активного экземпляра.
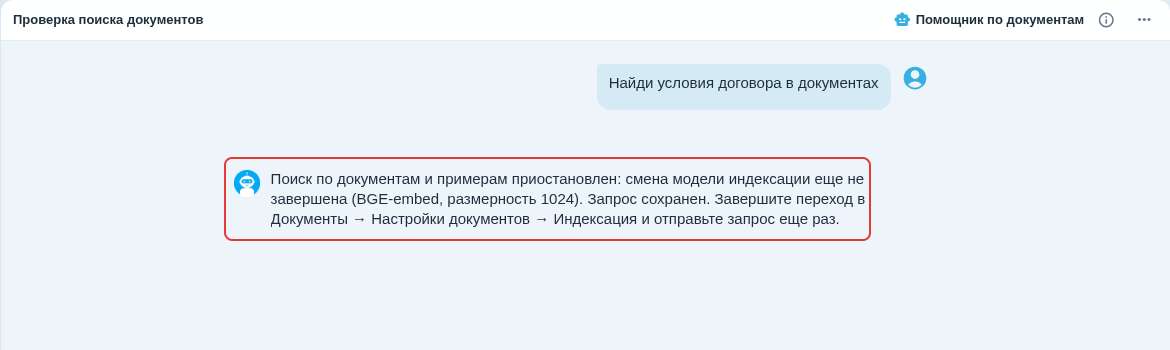
Пояснение незавершенного перехода индексации в Чате. Интерфейс на русском языке.
Для администратора: другая размерность#
Для размерности, отличной от 384 и 1024, после миграций версии 2.5.1 и до сохранения новой Модели необходимо подготовить индекс для нужного Аккаунта. Полный SQL, проверка и команды для стандартной клиентской установки приведены в разделе Дополнительная размерность после обновления инструкции по подготовке индексов. Можно скопировать SQL оттуда в локальный файл, необходимо указать числовой идентификатор Аккаунта и фактическую размерность Модели. После успешного выполнения команды необходимо подтвердить переход в карточке Модели кнопкой "Подтвердить переключение и переиндексацию".