
Cambiar el modelo de indexación de documentos#
Esta guía explica cómo cambiar el modelo que crea los vectores para buscar en los documentos. Al cambiar el modelo o la dimensión, se eliminan los vectores anteriores y se recalculan a partir de los fragmentos de texto guardados. El texto reconocido permanece; los archivos sin fragmentos guardados se leen de nuevo. La búsqueda por contenido puede no estar disponible durante el cambio, y los resultados pueden estar incompletos hasta que termine el procesamiento de los archivos. Programe el cambio para un momento adecuado. Los nombres de navegación se traducen en esta guía; la interfaz de la versión 2.5.1 está disponible en ruso e inglés. A continuación, los estados y el botón de reindexación se citan como aparecen en la interfaz inglesa.
Antes de empezar#
- Asignar el modelo predeterminado requiere
ai_models:read,ai_models:update,api:read,api:updateydocuments:read. Cambiar parámetros en Documentos requieredocuments:update. Crear un modelo o instancia requiere ademásai_models:create. - Averigüe la dimensión real de los vectores del nuevo modelo. Es necesario introducir el número que devuelve: un entero de 32 a 2000. Al actualizar de 2.5.0 a 2.5.1, prepare los índices 384 y 1024. Si la versión actual es anterior a 2.5.0, acuerde primero la ruta de actualización con el equipo de soporte. Para cualquier otra dimensión, un administrador debe preparar primero el índice de búsqueda.
- El modelo debe admitir Indexing y tener exactamente una instancia activa. Varias instancias del mismo modelo pueden devolver vectores incompatibles.
- No cambie la dirección o la ruta de la instancia activa del modelo de indexación actual para dirigirla a otra fuente de vectores: el sistema rechaza ese cambio. Cree un modelo y una instancia nuevos y asigne el modelo como predeterminado de indexación en su ficha.
- Los fragmentos añadidos solo mediante la API reciben nuevos vectores a partir de su texto guardado. Si también cambia el tamaño o la superposición, guárdelos fuera del sistema: sin archivo de origen no pueden dividirse de nuevo.
Ejemplo: BGE-M3 mediante vLLM#
En un servidor con GPU, inicie una instancia independiente de vLLM para el modelo de indexación. Este ejemplo utiliza vLLM 0.27.1 y BAAI/bge-m3 (vLLM debe estar instalado y los archivos del modelo deben estar disponibles):
vllm serve BAAI/bge-m3 --runner pooling --pooler-config.task embed \
  --hf-overrides '{"architectures":["BgeM3EmbeddingModel"]}' \
  --host 0.0.0.0 --port 8001
En el servidor vLLM, compruebe que cada vector contiene 1024 números (se necesita jq):
curl -fsS http://127.0.0.1:8001/v1/embeddings \
  -H 'Content-Type: application/json' \
  -d '{"model":"BAAI/bge-m3","input":["test"]}' \
  | jq '.data[0].embedding | length'
En Modelos, cree un modelo con soporte de Indexing y una instancia local activa. Indique la ruta BAAI/bge-m3, el puerto 8001 y una dirección de vLLM accesible desde el contenedor de Sherpa AI Server. Si vLLM está en otro servidor, use su nombre de red o IP. Dentro del contenedor, 127.0.0.1 se refiere al propio contenedor. Deje vacía la ruta adicional de la API.
Configure el formato de la API de embeddings antes de asignar el modelo predeterminado. El campo "Embeddings API format" está disponible para instancias locales de modelos con soporte de Indexing. Actualizar una instancia existente requiere ai_models:update.
- En la pantalla Models, seleccione el modelo necesario y abra la edición de su instancia local.
- En el campo “Embeddings API format”, seleccione “OpenAI (/v1/embeddings)” y haga clic en “OK”.
- Vuelva a abrir la instancia y compruebe que se ha guardado el formato seleccionado. Las modificaciones posteriores conservan este formato y los parámetros de conexión adicionales.
“Automatic (by instance type)” mantiene la selección anterior de API según el tipo de instancia. “vLLM (/v2/embed)” y “API v2 (/v2/embed)” utilizan /v2/embed. “Cohere (/v2/embed, input_type)” también envía input_type. BGE-M3 en este ejemplo requiere OpenAI.
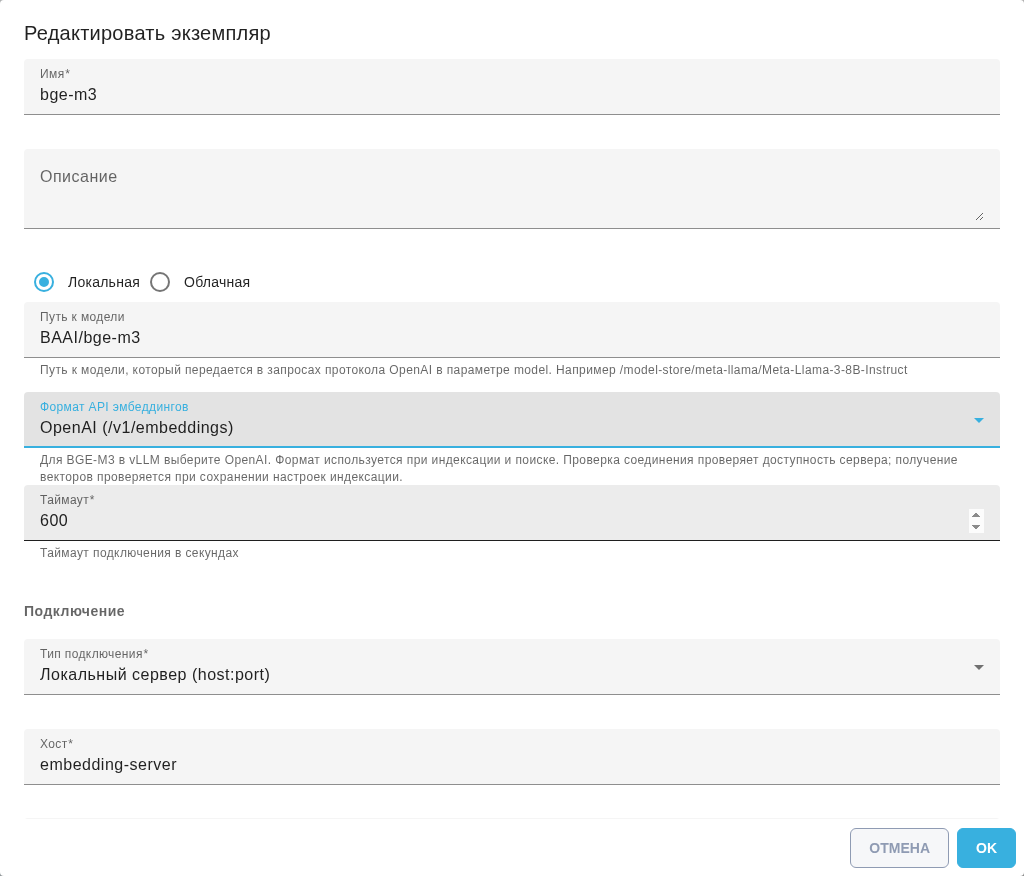
Ventana Edit Instance: formato OpenAI seleccionado para BGE-M3 (interfaz en ruso).
Si el campo “Embeddings API format” no aparece, la versión instalada todavía no permite seleccionarlo mediante el formulario. Se debe ejecutar GET /api/v1/models/{model_guid}/instances/{instance_guid}, obtener el objeto completo data.connection_params, añadir "embed_format": "openai" y enviar el objeto completo actualizado en un PATCH a la misma URL como {"connection_params": {…}}. Un PATCH reemplaza todo el objeto, por lo que se deben conservar todos los campos de conexión y autenticación. Un GET posterior debe confirmar el valor openai. En una versión sin este campo, no se debe guardar la instancia mediante el formulario: eliminará la configuración.
El formato OpenAI dirige las solicitudes de Sherpa a /v1/embeddings. La prueba de conexión del formulario comprueba la disponibilidad del servidor. Sherpa verifica la generación real de vectores al guardar los ajustes de indexación. Después, se deben seguir los pasos siguientes para seleccionar el nuevo modelo y la dimensión 1024.
Funcionamiento sin el modelo local de Embed#
Si se selecciona un modelo externo para la indexación, por ejemplo mediante vLLM, el administrador del servidor puede desactivar la carga del modelo local dentro de aiserver-embed. El contenedor sigue siendo necesario para procesar documentos, OCR, fragmentos de texto, BM25, almacenamiento de vectores y búsquedas. EMBED_MODEL_API_BASE_URL debe apuntar a este servicio de Sherpa, no a un servidor vLLM estándar.
- Configure el modelo externo y asígnelo como predeterminado de indexación en su ficha de Models. Compruebe la indexación y la búsqueda con un documento de prueba.
- Indique lo siguiente en el archivo
.envde la instalación:
EMBED_LOCAL_MODEL_ENABLED=false
- Desde el directorio de instalación, vuelva a crear solo el contenedor Embed. Para el archivo estándar
docker-compose.yml:
docker compose up -d --no-deps --force-recreate aiserver-embed
Si la instalación utiliza otro archivo Compose o nombre de proyecto, indique los mismos parámetros -f y -p utilizados para iniciarla. Volver a crear el contenedor interrumpe brevemente el procesamiento de documentos y la búsqueda. Tras el inicio, compruebe de nuevo el documento de prueba. Los registros mostrarán Local embedding model disabled by EMBED_LOCAL_MODEL_ENABLED.
Con false, el modelo local no se carga ni se descarga, aunque sus pesos ya existan. Los pesos guardados permanecen en disco. EMBED_DOWNLOAD_MODEL=false solo impide descargar pesos que faltan. No desactiva la carga de un modelo guardado. Los métodos locales /v1/embeddings y /v2/embed devuelven HTTP 503 model_not_loaded. Los vectores deben proceder del modelo externo seleccionado.
El valor predeterminado es EMBED_LOCAL_MODEL_ENABLED=true. Para restaurar el modelo local, establezca true y vuelva a crear el contenedor. Si faltan los pesos, su descarga también requiere EMBED_DOWNLOAD_MODEL=true.
Cambiar el modelo#
Para cambiar el modelo de indexación:
En Models, compruebe que el modelo admite Indexing y tiene exactamente una instancia activa disponible. Si no existe la ficha, cree el modelo y la instancia o contacte con el administrador.
Marque Default en la fila Indexing de la nueva ficha. Introduzca la dimensión real en la ventana Default indexing model. Cambiar solo la dimensión en la configuración de Documentos no selecciona otro modelo.
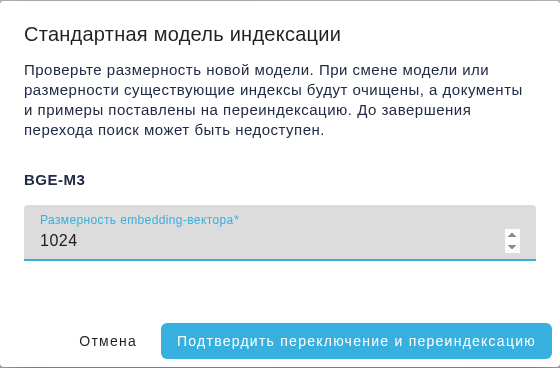
Ventana Default indexing model: dimensión 1024 para BGE-M3. Interfaz en ruso.
Haga clic en "Confirm switch and reindexing" para validar e iniciar la transición. El servidor comprueba el modelo, la dimensión y el índice de búsqueda. Tras la validación guarda el modelo y la dimensión, elimina los vectores anteriores y pone en cola los documentos de indexación automática. Se conserva el texto guardado. Solo los archivos sin texto guardado requieren OCR de nuevo. Se conservan los originales. No es necesario pulsar "Delete all vectors and reindex" por separado. Cambiar el modelo también inicia una transición si la dimensión permanece igual.
Es necesario esperar a que se procesen los documentos: Pending → Processing → Ready. Si un archivo muestra Awaiting manual indexing, ábralo y pulse Re-index; después, espere a que aparezca Ready. Los archivos con estado Not indexed no se indexan. El servidor reindexa automáticamente los ejemplos de respuestas de los asistentes.
Busque contenido de un documento conocido y confirme que los archivos necesarios hayan llegado a Ready. Si un archivo muestra Error, consulte y resuelva la causa. Después, pulse Re-index para ese archivo. Para volver a procesar todos los archivos, use Delete all vectors and reindex por separado.
El estado de transición ready indica que terminó el cambio de ajustes; no significa que todos los archivos hayan llegado a Ready. Si una respuesta de la API muestra queued_files, ese valor cuenta los archivos puestos en cola, no los ya procesados. Es necesario comprobar los estados de los documentos y la búsqueda cuando termine la indexación.
Sin un modelo predeterminado de indexación, la configuración de Documentos muestra "Not assigned". Las operaciones vectoriales devuelven 404 model_not_found sin utilizar .env. Quitar la asignación en la ficha conserva los archivos y vectores, pero la indexación y la búsqueda vectorial quedan deshabilitadas hasta asignar un modelo. Una instancia activa no disponible devuelve 503 model_unavailable.
Ejemplos#
- 384 → 1024. Seleccione un nuevo modelo que devuelva vectores de dimensión 1024, introduzca 1024 y haga clic en "Confirm switch and reindexing". Es necesario esperar a que se reindexen los archivos y compruebe la búsqueda.
- 1024 → 384. Seleccione un modelo que devuelva vectores de dimensión 384, introduzca 384 y siga los mismos pasos.
- 384 → 384, otro modelo. Seleccione otro modelo, mantenga 384 y haga clic en "Confirm switch and reindexing". El cambio de modelo inicia la reindexación aunque la dimensión no cambie.
Si cambia la división del texto#
Al cambiar "Chunk size" o "Chunk overlap", aparece un icono de advertencia junto al campo. Pase el cursor sobre él o selecciónelo con el teclado. Guardar elimina los fragmentos anteriores y vuelve a leer los archivos. Los escaneos requieren OCR de nuevo y pueden tardar mucho más. Si también cambia el modelo o la dimensión, los nuevos vectores se crean tras leer los archivos.
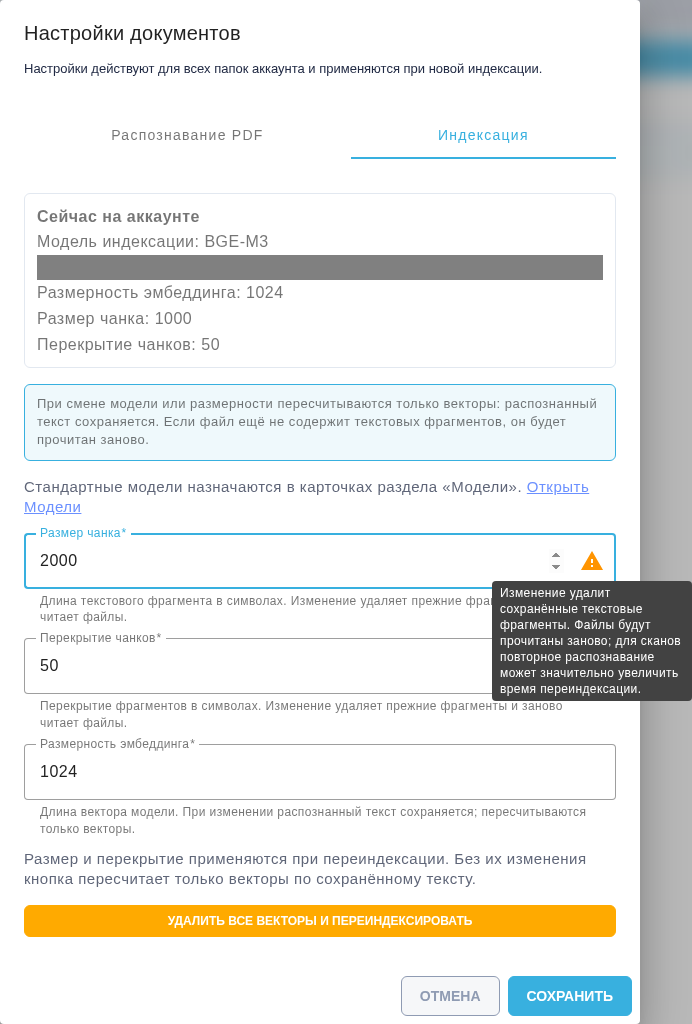
Ventana Documents settings, pestaña Indexing: advertencia al cambiar el tamaño del fragmento. Interfaz en ruso.
Si el tamaño y la superposición no cambian, Delete all vectors and reindex recalcula solo los vectores a partir del texto guardado. No hay una orden separada para repetir el OCR de todos los archivos. Los archivos sin fragmentos guardados se leen de nuevo.
Si se rechaza o interrumpe el cambio#
Si falla la comprobación previa porque el modelo no está disponible, la dimensión es incorrecta o el índice no está preparado, la causa debe resolverse y los ajustes guardarse de nuevo. Si se rechaza un cambio simultáneo del tamaño o la superposición debido a fragmentos añadidos solo mediante la API, su texto y metadatos deben guardarse fuera del sistema, los fragmentos o su archivo eliminarse y la operación repetirse. Cambiar solo el modelo o la dimensión conserva los fragmentos de la API.
El botón "Resume transition", los campos bloqueados y los contadores de trabajo pendiente están disponibles a partir de la versión 2.5.4. En la versión 2.5.3, el botón "Save" permite continuar la transición.
En un servidor de producción, los nuevos intentos de transición, la reindexación y la eliminación de datos deben acordarse previamente con el administrador responsable.
Una transición incompleta requiere los siguientes pasos y los permisos documents:update y ai_models:read. Los nombres de los controles corresponden a la interfaz en inglés.
- Es necesario cerrar la ventana de ajustes, seleccionar "Document processing" en la pantalla Documentos y abrir la pestaña "Indexing".
- Es necesario conservar el modelo, la dimensión, el tamaño y la superposición de fragmentos cargados del servidor. Son los valores de la transición iniciada y pueden diferir de los anteriores al primer intento. La nueva interfaz bloquea estos campos y los ajustes de reconocimiento. "Currently on this account" muestra la configuración guardada. Los contadores indican los archivos y las muestras de respuestas de asistentes pendientes. Se actualizan al volver a abrir la ventana o después de un error.
- Tras resolver la causa indicada, es necesario seleccionar "Resume transition". En la versión 2.5.3, es necesario seleccionar "Save" sin modificar ninguno de los cuatro parámetros. El servidor continúa el trabajo restante. Si falla el nuevo intento, debe proporcionarse al administrador la hora del error y el identificador del archivo.
- Al finalizar la transición, es necesario esperar el estado "Ready" de los documentos necesarios y comprobar la búsqueda con un fragmento conocido. El estado
readyconfirma la transición de ajustes, no la indexación de todos los archivos. Tras recuperar la búsqueda, debe enviarse de nuevo la solicitud del Chat. - El nuevo tamaño y la superposición deben guardarse por separado después de finalizar la transición.
Ejemplo: una cuenta ha iniciado una transición con BGE-embed, dimensión 1024, tamaño de fragmentos 4000 y superposición 200. Para finalizarla, es necesario seleccionar "Resume transition" en la pestaña "Indexing" de "Document settings" de la interfaz en inglés. Estos valores se mantienen sin cambios. Los nuevos valores 1000 y 50 deben guardarse por separado después de finalizar.
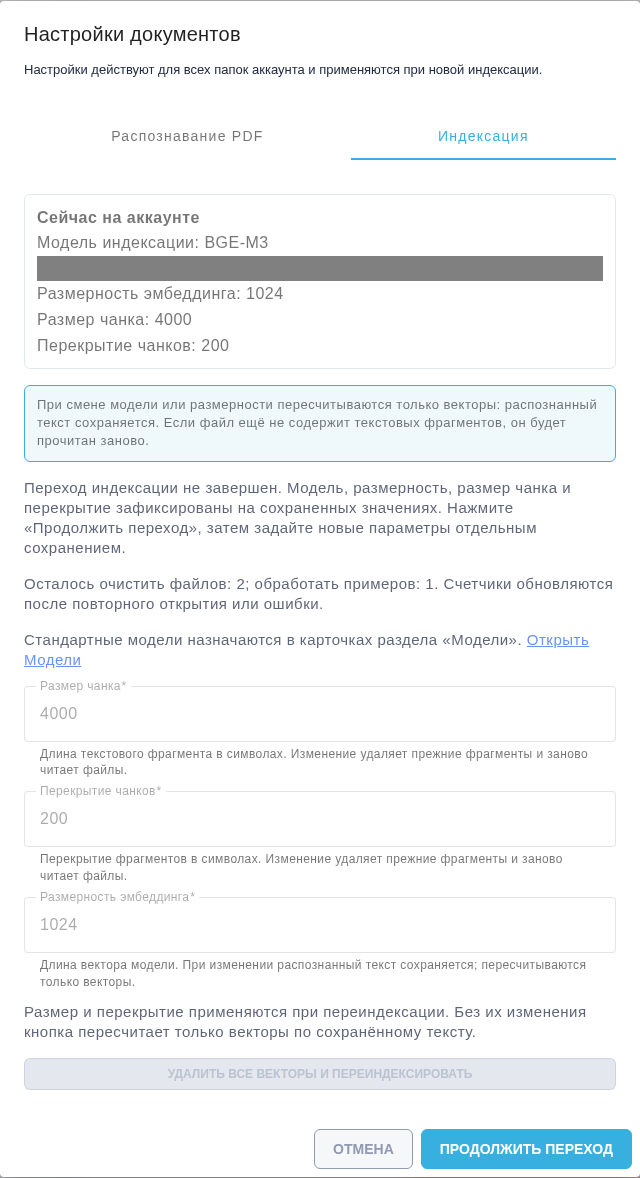
Pestaña "Indexing" de "Document settings". Interfaz en ruso.
La nueva interfaz guarda el reconocimiento y la indexación por separado. Para modificar ambos grupos, primero es necesario guardar el reconocimiento sin cambiar la indexación. Después debe abrirse de nuevo la ventana y guardarse la indexación. El reconocimiento no puede modificarse durante una transición incompleta. Continuar no sobrescribe el OCR ni el modelo de reconocimiento predeterminado. Si el guardado del OCR es parcial, la ventana vuelve a cargar los valores almacenados. Deben comprobarse antes de repetir. El modelo de reconocimiento predeterminado debe comprobarse en la pantalla Modelos. En la versión 2.5.3, los ajustes de OCR pueden haberse guardado por separado tras un error.
A partir de la versión 2.5.4, los nuevos intentos omiten los archivos y las muestras completados. Si falla la restauración de fragmentos guardados de un archivo con indexación manual, permanece pendiente hasta que un nuevo intento tenga éxito. Se conservan los archivos originales. No deben eliminarse ni borrarse manualmente el estado pending solo para recuperar la búsqueda.
El administrador debe distinguir un tiempo de espera agotado, una respuesta de error del servidor, una conexión no disponible y un error de base de datos. La actualización dispone de un tiempo de espera separado para eliminar vectores: EMBED_CLEANUP_TIMEOUT_SECONDS, de 120 segundos por defecto y con enteros de 1 a 3600. Los valores incorrectos usan el predeterminado. Este parámetro no cambia los tiempos de espera de las solicitudes a modelos. Un proxy puede interrumpir antes la solicitud completa. Tras resolver la causa, es necesario repetir con la misma configuración. El servidor de embeddings puede terminar la eliminación después del tiempo de espera, por lo que el error no demuestra que los datos no hayan cambiado.
Comprobar la ruta del modelo y la causa del error#
Para comprobar la conexión, es necesario abrir la única instancia activa del modelo de indexación seleccionado en la pantalla Modelos. En la interfaz en inglés, el campo "Model path" debe contener el identificador del servidor de embeddings, por ejemplo BAAI/bge-m3. Una instancia en la nube puede utilizar el parámetro de conexión model. Si ambos valores están definidos, prevalece "Model path". El identificador se puede comprobar mediante /v1/models del servidor seleccionado. No debe utilizarse un campo vacío para seleccionar el modelo de chat.
Se rechaza una ruta vacía antes de contactar con el servidor. "Open Models" en la configuración de Documentos abre las fichas donde se establecen el modelo predeterminado y los parámetros de la instancia. Si el servidor rechaza el identificador o devuelve otra dimensión, el mensaje indica el modelo y los parámetros que se deben comprobar.
Ejemplo: la limpieza de "document.pdf" se interrumpió porque el servidor de embeddings no estaba disponible. El mensaje muestra el archivo y la causa. El administrador debe restablecer la conexión y reanudar la transición con los parámetros guardados. A partir de la versión 2.5.4 no se vuelven a limpiar los archivos ya completados.
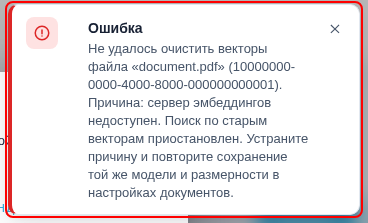
Error de limpieza de vectores. La interfaz está en ruso.
Si el Chat no puede buscar documentos#
La solicitud del Chat se guarda cuando se produce un conflicto de búsqueda conocido. En lugar de una respuesta del modelo aparece una explicación sobre la transición incompleta, una dimensión diferente o un modelo del vector de búsqueda que no coincide. La respuesta también puede indicar que el modelo de indexación no pudo crear un vector de búsqueda. Indica el modelo y la dimensión de la configuración. Recargar la página no ejecuta automáticamente la solicitud rechazada.
- El administrador debe comprobar la pestaña "Indexing" de la ventana emergente "Document settings". Si la limpieza no ha terminado, es necesario resolver la causa indicada y continuar con el mismo modelo, dimensión, tamaño y superposición.
- Tras finalizar la transición, es necesario esperar a que los documentos requeridos estén listos y comprobar la búsqueda con un fragmento conocido. El estado
readyno confirma que todos los archivos estén listos. - Tras restaurar la indexación, el usuario debe enviar de nuevo la solicitud en el Chat. Si la dimensión o la fuente de vectores no coincide, es necesario comprobar el modelo seleccionado y reindexar los documentos. Si el modelo no está disponible, debe comprobarse la conexión y la ruta de su instancia activa.
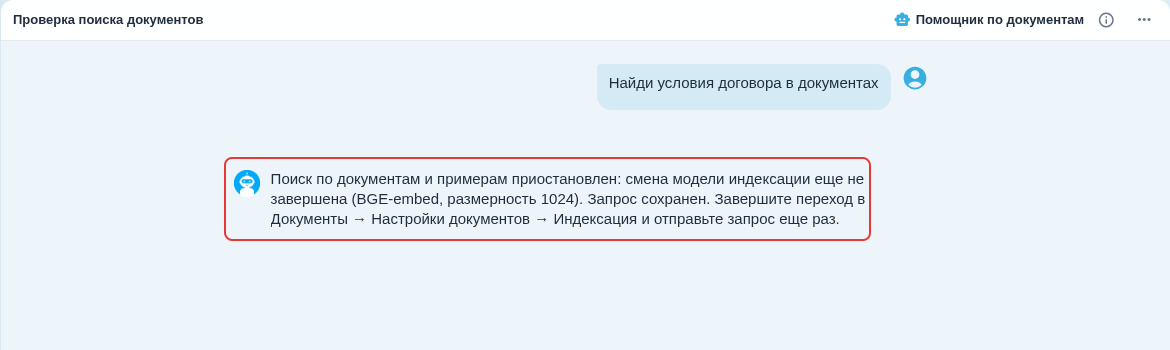
Explicación de una transición de indexación incompleta en el Chat. Interfaz en ruso.
Para administradores: otra dimensión#
Para una dimensión distinta de 384 o 1024, prepare el índice de la cuenta después de las migraciones de la versión 2.5.1 y antes de guardar el nuevo modelo. El SQL completo, las comprobaciones y los comandos para la instalación estándar del cliente se encuentran en la sección "Dimensiones adicionales después de la actualización" de la guía de preparación de índices. Copie el SQL desde esa página a un archivo local e indique el ID numérico de la cuenta y la dimensión real del modelo. Cuando el comando termine correctamente, confirme la transición en la ficha con "Confirm switch and reindexing".