
Alterar o modelo de indexação de documentos#
Este guia explica como alterar o modelo que cria vetores para a pesquisa em documentos. Ao alterar o modelo ou a dimensão, os vetores antigos são removidos e recalculados a partir dos trechos de texto salvos. O texto reconhecido permanece; arquivos sem trechos salvos são lidos novamente. A pesquisa por conteúdo pode ficar indisponível durante a alteração, e os resultados podem ficar incompletos até o processamento dos arquivos terminar. Programe a alteração para um momento adequado. Os nomes de navegação estão traduzidos neste guia; a interface da versão 2.5.1 está disponível em russo e inglês. A seguir, os status e o botão de reindexação são citados como aparecem na interface em inglês.
Antes de começar#
- Atribuir o modelo padrão exige
ai_models:read,ai_models:update,api:read,api:updateedocuments:read. Alterar parâmetros em Documentos exigedocuments:update. Criar um modelo ou instância exige tambémai_models:create. - É necessário verificar a dimensão real dos vetores do novo modelo. É necessário informar o número retornado por ele: um inteiro de 32 a 2000. Ao atualizar de 2.5.0 para 2.5.1, prepare os índices 384 e 1024. Se a versão atual for anterior à 2.5.0, combine primeiro o caminho de atualização com a equipe de suporte. Para outra dimensão, um administrador deve preparar o índice de pesquisa antes.
- O modelo deve ter suporte a Indexing e exatamente uma instância ativa. Várias instâncias do mesmo modelo podem retornar vetores incompatíveis.
- Não altere o endereço ou o caminho da instância ativa do modelo de indexação atual para apontá-la para outra fonte de vetores: o sistema rejeita essa alteração. Crie um modelo e uma instância separados e atribua o modelo como padrão de indexação na ficha.
- Trechos adicionados somente pela API recebem novos vetores a partir do texto salvo. Se também alterar o tamanho ou a sobreposição, salve esses trechos fora do sistema: sem arquivo de origem eles não podem ser divididos novamente.
Exemplo: BGE-M3 com vLLM#
Em um servidor com GPU, inicie uma instância separada do vLLM para o modelo de indexação. Este exemplo usa vLLM 0.27.1 e BAAI/bge-m3 (o vLLM deve estar instalado e os arquivos do modelo devem estar disponíveis):
vllm serve BAAI/bge-m3 --runner pooling --pooler-config.task embed \
  --hf-overrides '{"architectures":["BgeM3EmbeddingModel"]}' \
  --host 0.0.0.0 --port 8001
No servidor vLLM, confirme que cada vetor contém 1024 números (é necessário ter jq):
curl -fsS http://127.0.0.1:8001/v1/embeddings \
  -H 'Content-Type: application/json' \
  -d '{"model":"BAAI/bge-m3","input":["test"]}' \
  | jq '.data[0].embedding | length'
Em Modelos, crie um modelo com suporte a Indexing e uma instância local ativa. Informe o caminho BAAI/bge-m3, a porta 8001 e um endereço do vLLM acessível pelo contêiner do Sherpa AI Server. Se o vLLM estiver em outro servidor, use o nome de rede ou IP. Dentro do contêiner, 127.0.0.1 aponta para o próprio contêiner. Deixe o caminho adicional da API vazio.
Configure o formato da API de embeddings antes de atribuir o padrão. O campo "Embeddings API format" está disponível para instâncias locais de modelos com suporte a Indexing. Atualizar uma instância existente exige ai_models:update.
- Na tela Models, selecione o modelo necessário e abra a edição de sua instância local.
- No campo “Embeddings API format”, selecione “OpenAI (/v1/embeddings)” e clique em “OK”.
- Abra a instância novamente e verifique se o formato selecionado foi salvo. As alterações posteriores preservam esse formato e os parâmetros de conexão adicionais.
“Automatic (by instance type)” mantém a seleção anterior da API com base no tipo de instância. “vLLM (/v2/embed)” e “API v2 (/v2/embed)” usam /v2/embed. “Cohere (/v2/embed, input_type)” também envia input_type. O BGE-M3 neste exemplo requer OpenAI.
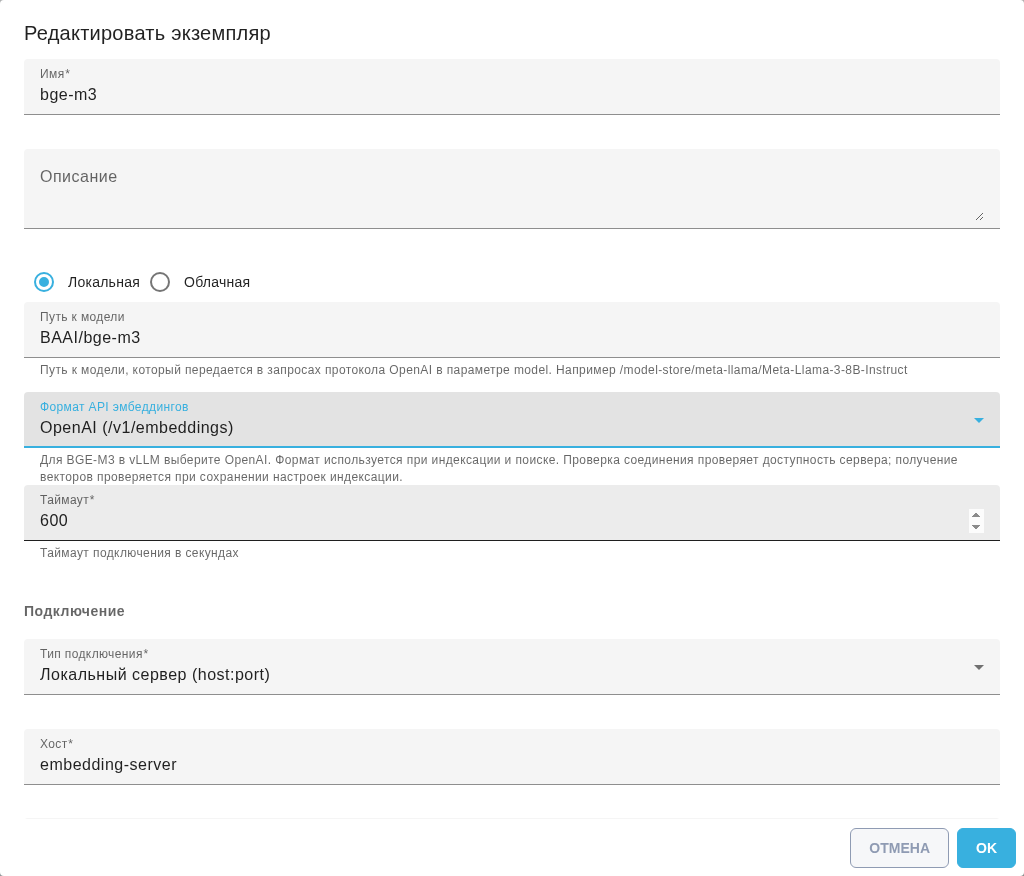
Janela Edit Instance: formato OpenAI selecionado para BGE-M3 (interface em russo).
Se o campo “Embeddings API format” não aparecer, a versão instalada ainda não permite a seleção pelo formulário. É necessário executar GET /api/v1/models/{model_guid}/instances/{instance_guid}, obter o objeto completo data.connection_params, adicionar "embed_format": "openai" e enviar o objeto completo atualizado em um PATCH para a mesma URL como {"connection_params": {…}}. Um PATCH substitui todo o objeto, portanto todos os campos de conexão e autenticação devem ser mantidos. Um GET posterior deve confirmar o valor openai. Em uma versão sem esse campo, a instância não deve ser salva pelo formulário: ele removerá a configuração.
O formato OpenAI direciona as solicitações do Sherpa para /v1/embeddings. O teste de conexão do formulário verifica a disponibilidade do servidor. O Sherpa verifica a geração real de vetores ao salvar as configurações de indexação. Depois, as etapas abaixo devem ser seguidas para selecionar o novo modelo e a dimensão 1024.
Operação sem o modelo local do Embed#
Se um modelo externo estiver selecionado para indexação, por exemplo via vLLM, o administrador do servidor poderá desativar o carregamento do modelo local dentro de aiserver-embed. O contêiner continua necessário para processamento de documentos, OCR, fragmentos de texto, BM25, armazenamento de vetores e pesquisa. EMBED_MODEL_API_BASE_URL deve apontar para esse serviço do Sherpa, e não para um servidor vLLM padrão.
- Configure o modelo externo e atribua-o como padrão de indexação na ficha em Models. Verifique a indexação e a busca com um documento de teste.
- Defina o seguinte no arquivo
.envda instalação:
EMBED_LOCAL_MODEL_ENABLED=false
- No diretório de instalação, recrie apenas o contêiner Embed. Para o arquivo padrão
docker-compose.yml:
docker compose up -d --no-deps --force-recreate aiserver-embed
Se a instalação usar outro arquivo Compose ou nome de projeto, informe os mesmos parâmetros -f e -p usados para iniciá-la. A recriação interrompe brevemente o processamento de documentos e a pesquisa. Após a inicialização, verifique novamente o documento de teste. Os logs mostrarão Local embedding model disabled by EMBED_LOCAL_MODEL_ENABLED.
Com false, o modelo local não é carregado nem baixado, mesmo que os pesos já existam. Os pesos salvos permanecem no disco. EMBED_DOWNLOAD_MODEL=false impede apenas o download de pesos ausentes. Não desativa o carregamento de um modelo salvo. Os métodos locais /v1/embeddings e /v2/embed retornam HTTP 503 model_not_loaded. Os vetores devem vir do modelo externo selecionado.
O padrão é EMBED_LOCAL_MODEL_ENABLED=true. Para restaurar o modelo local, defina true e recrie o contêiner. Se os pesos estiverem ausentes, o download também exigirá EMBED_DOWNLOAD_MODEL=true.
Alterar o modelo#
Para trocar o modelo de indexação:
Em Models, verifique se o modelo oferece suporte a Indexing e tem exatamente uma instância ativa disponível. Se não houver ficha, crie o modelo e a instância ou contate o administrador.
Marque Default na linha Indexing da nova ficha. Informe a dimensão real na janela Default indexing model. Alterar apenas a dimensão nas configurações de Documentos não seleciona outro modelo.
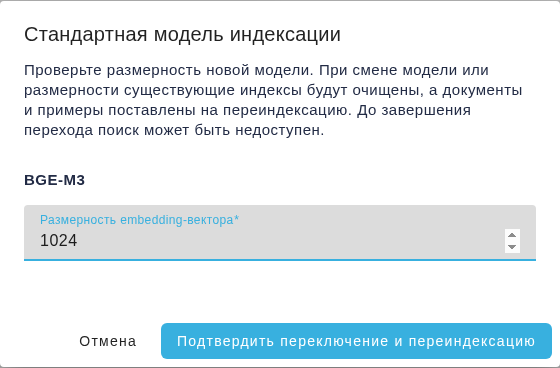
Janela Default indexing model: dimensão 1024 para BGE-M3. Interface em russo.
Clique em "Confirm switch and reindexing" para validar e iniciar a transição. O servidor verifica o modelo, a dimensão e o índice de busca. Após a validação, salva o modelo e a dimensão, remove os vetores antigos e coloca os documentos de indexação automática na fila. O texto salvo é mantido. Somente arquivos sem texto salvo exigem novo OCR. Os arquivos de origem são mantidos. Não é necessário clicar em "Delete all vectors and reindex" separadamente. Trocar de modelo também inicia uma transição quando a dimensão permanece igual.
É necessário aguardar o processamento dos documentos: Pending → Processing → Ready. Se um arquivo mostrar Awaiting manual indexing, abra-o e clique em Re-index; depois, aguarde Ready. Arquivos com status Not indexed não são indexados. O servidor reindexa automaticamente os exemplos de respostas dos assistentes.
Pesquise o conteúdo de um documento conhecido e confirme que os arquivos necessários chegaram a Ready. Se um arquivo mostrar Error, leia e resolva a causa. Depois, clique em Re-index para esse arquivo. Para processar todos os arquivos novamente, use Delete all vectors and reindex separadamente.
O status da transição ready indica que a alteração das configurações terminou; isso não significa que todos os arquivos chegaram a Ready. Se uma resposta da API mostrar queued_files, esse valor conta os arquivos colocados na fila, não os já processados. É necessário verificar os status dos documentos e a pesquisa após a indexação terminar.
Sem um padrão de indexação, as configurações de Documentos mostram "Not assigned". As operações vetoriais retornam 404 model_not_found sem usar .env. Remover a atribuição na ficha mantém arquivos e vetores, mas a indexação e a busca vetorial ficam indisponíveis até atribuir um modelo. Uma instância ativa indisponível retorna 503 model_unavailable.
Exemplos#
- 384 → 1024. Selecione um novo modelo que retorne vetores de dimensão 1024, informe 1024 e clique em "Confirm switch and reindexing". É necessário aguardar a reindexação dos arquivos e verifique a pesquisa.
- 1024 → 384. Selecione um modelo que retorne vetores de dimensão 384, informe 384 e siga as mesmas etapas.
- 384 → 384, outro modelo. Selecione outro modelo, mantenha 384 e clique em "Confirm switch and reindexing". A alteração do modelo inicia a reindexação mesmo que a dimensão não mude.
Se a divisão do texto mudar#
Ao alterar Tamanho do chunk ou Sobreposição de chunks, um ícone de aviso aparece ao lado do campo. Passe o cursor sobre ele ou selecione-o com o teclado. Salvar remove os trechos antigos e lê os arquivos novamente. Digitalizações exigem novo OCR e podem demorar muito mais. Se o modelo ou a dimensão também mudar, novos vetores são criados após a leitura dos arquivos.
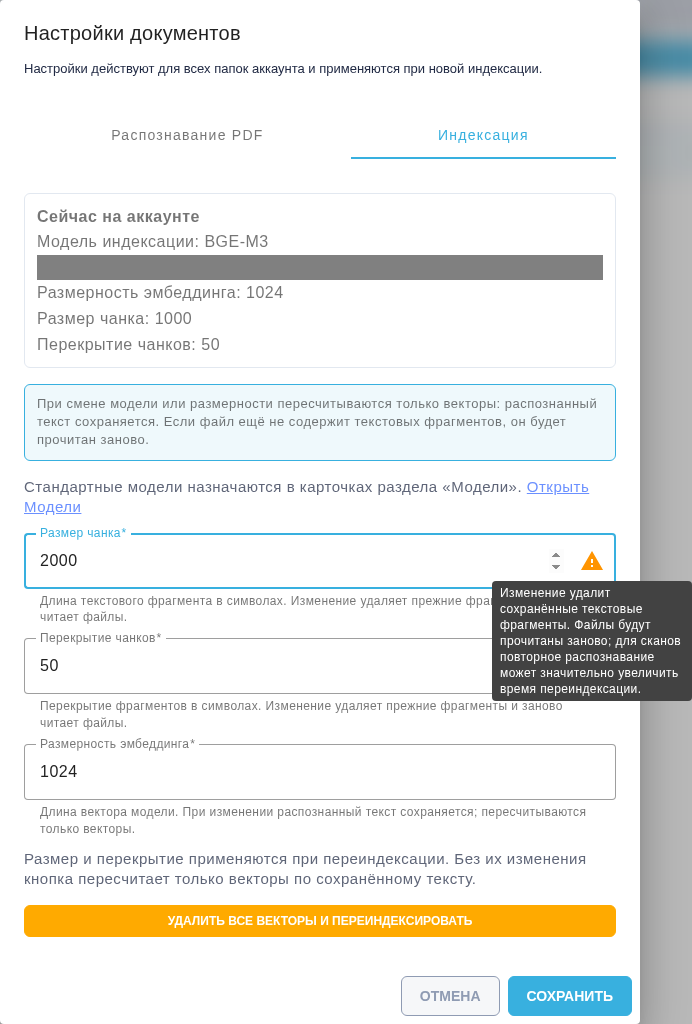
Janela Documents settings, aba Indexing: aviso ao alterar o tamanho do trecho. Interface em russo.
Com tamanho e sobreposição inalterados, Delete all vectors and reindex recalcula apenas os vetores a partir do texto salvo. Não existe um comando separado para repetir o OCR de todos os arquivos. Arquivos sem trechos salvos são lidos novamente.
Se a alteração for rejeitada ou interrompida#
Se a verificação inicial falhar porque o modelo está indisponível, a dimensão está incorreta ou o índice não foi preparado, a causa deve ser resolvida e as configurações salvas novamente. Se uma alteração simultânea do tamanho ou da sobreposição for rejeitada por trechos adicionados somente pela API, o texto e os metadados devem ser salvos fora do sistema, os trechos ou seu arquivo removidos e a operação repetida. Alterar apenas o modelo ou a dimensão preserva os trechos da API.
O botão "Resume transition", os campos bloqueados e os contadores de trabalho restante estão disponíveis a partir da versão 2.5.4. Na versão 2.5.3, o botão "Save" retoma a transição.
Em um servidor de produção, novas tentativas de transição, reindexação e exclusão de dados devem ser acordadas previamente com o administrador responsável.
Uma transição incompleta exige as etapas abaixo e as permissões documents:update e ai_models:read. Os nomes dos controles correspondem à interface em inglês.
- É necessário fechar a janela de configurações, selecionar "Document processing" na tela Documentos e abrir a aba "Indexing".
- É necessário manter o modelo, a dimensão, o tamanho e a sobreposição dos trechos carregados do servidor. São os valores da transição iniciada e podem diferir dos anteriores à primeira tentativa. A nova interface bloqueia esses campos e as configurações de reconhecimento. "Currently on this account" mostra a configuração salva. Os contadores indicam os arquivos e as amostras de respostas de assistentes restantes. Eles são atualizados ao reabrir a janela ou após um erro.
- Após resolver a causa exibida, é necessário selecionar "Resume transition". Na versão 2.5.3, é necessário selecionar "Save" sem alterar nenhum dos quatro parâmetros. O servidor continua o trabalho restante. Se a nova tentativa falhar, o administrador deve receber o horário do erro e o identificador do arquivo.
- Ao concluir a transição, é necessário aguardar o status "Ready" dos documentos necessários e verificar a busca usando um trecho conhecido. O estado
readyconfirma a transição das configurações, não a indexação de todos os arquivos. Após recuperar a busca, a solicitação do Chat deve ser enviada novamente. - O novo tamanho e a sobreposição devem ser salvos separadamente após a conclusão da transição.
Exemplo: uma conta iniciou uma transição com BGE-embed, dimensão 1024, tamanho dos trechos 4000 e sobreposição 200. Para concluir, é necessário selecionar "Resume transition" na aba "Indexing" de "Document settings" da interface em inglês. Esses valores permanecem inalterados. Os novos valores 1000 e 50 devem ser salvos separadamente após a conclusão.
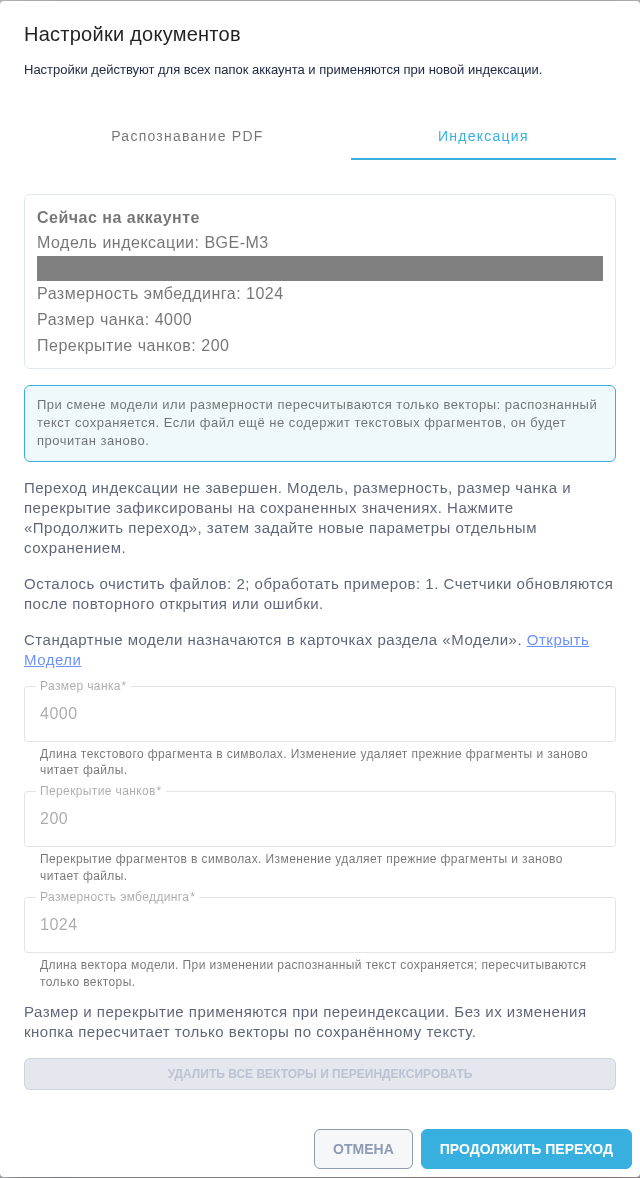
Aba "Indexing" de "Document settings". Interface em russo.
A nova interface salva reconhecimento e indexação separadamente. Para alterar os dois grupos, primeiro é necessário salvar o reconhecimento sem alterar a indexação. Depois é necessário reabrir a janela e salvar a indexação. O reconhecimento não pode ser alterado durante uma transição incompleta. Retomar não sobrescreve o OCR nem o modelo de reconhecimento padrão. Se o salvamento do OCR for parcial, a janela recarrega os valores armazenados. Eles devem ser verificados antes de repetir. O modelo de reconhecimento padrão deve ser verificado na tela Modelos. Na versão 2.5.3, as configurações de OCR podem ter sido salvas separadamente após um erro.
A partir da versão 2.5.4, novas tentativas ignoram os arquivos e as amostras concluídos. Se a restauração dos trechos salvos de um arquivo com indexação manual falhar, ele permanece pendente até uma tentativa bem-sucedida. Os arquivos originais são preservados. Eles não devem ser excluídos, nem o estado pending removido manualmente, apenas para recuperar a busca.
O administrador deve distinguir tempo de espera esgotado, resposta de erro do servidor, conexão indisponível e erro do banco de dados. A atualização tem um tempo de espera separado para excluir vetores: EMBED_CLEANUP_TIMEOUT_SECONDS, padrão de 120 segundos, aceitando inteiros de 1 a 3600. Valores inválidos usam o padrão. Esse parâmetro não altera os tempos de espera das solicitações aos modelos. Um proxy pode interromper a solicitação completa antes. Após resolver a causa, é necessário repetir com a mesma configuração. O servidor de embeddings pode concluir a exclusão após o tempo de espera, portanto o erro não prova que os dados permaneceram inalterados.
Verificar o caminho do modelo e a causa do erro#
Para verificar a conexão, é necessário abrir a única instância ativa do modelo de indexação selecionado na tela Modelos. Na interface em inglês, o campo "Model path" deve conter o identificador do servidor de embeddings, por exemplo BAAI/bge-m3. Uma instância na nuvem pode usar o parâmetro de conexão model. Quando ambos os valores estão definidos, "Model path" tem prioridade. O identificador pode ser verificado por meio de /v1/models do servidor selecionado. Um campo vazio não deve ser usado para selecionar o modelo de chat.
Um caminho vazio é rejeitado antes de contatar o servidor. "Open Models" nas configurações de Documentos abre as fichas onde são definidos o padrão e os parâmetros da instância. Se o servidor rejeitar o identificador ou retornar outra dimensão, a mensagem informa o modelo e os parâmetros a verificar.
Exemplo: a limpeza de "document.pdf" foi interrompida porque o servidor de embeddings estava indisponível. A mensagem mostra o arquivo e a causa. O administrador deve restabelecer a conexão e retomar a transição com os parâmetros salvos. A partir da versão 2.5.4, os arquivos já concluídos não são limpos novamente.
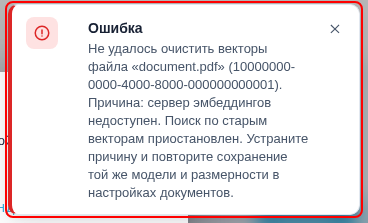
Erro de limpeza de vetores. A interface está em russo.
Se o Chat não conseguir buscar documentos#
A solicitação do Chat é salva quando ocorre um conflito de busca conhecido. Uma explicação sobre a transição incompleta, uma dimensão diferente ou um modelo do vetor de busca incompatível aparece em vez da resposta do modelo. A resposta também pode informar que o modelo de indexação não conseguiu criar um vetor de busca. Ela informa o modelo e a dimensão das configurações. Recarregar a página não executa automaticamente a solicitação recusada.
- O administrador deve verificar a aba "Indexing" da janela "Document settings". Se a limpeza não estiver concluída, é necessário resolver a causa exibida e continuar com o mesmo modelo, dimensão, tamanho e sobreposição.
- Após a conclusão da transição, é necessário aguardar os documentos necessários ficarem prontos e verificar a busca com um trecho conhecido. O estado
readynão confirma que todos os arquivos estejam prontos. - Após restaurar a indexação, o usuário deve enviar a solicitação no Chat novamente. Se a dimensão ou a origem dos vetores não corresponder, é necessário verificar o modelo selecionado e reindexar os documentos. Se o modelo estiver indisponível, é necessário verificar a conexão e o caminho de sua instância ativa.
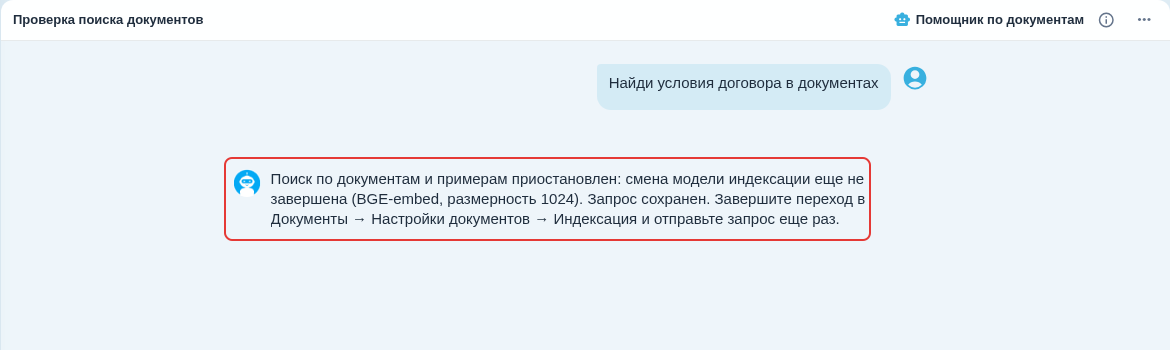
Explicação de uma transição de indexação incompleta no Chat. Interface em russo.
Para administradores: outra dimensão#
Para uma dimensão diferente de 384 ou 1024, prepare o índice da conta após as migrações da versão 2.5.1 e antes de salvar o novo modelo. O SQL completo, as verificações e os comandos para a instalação padrão do cliente estão na seção "Dimensões adicionais após a atualização" do guia de preparação de índices. Copie o SQL da página para um arquivo local e informe o ID numérico da conta e a dimensão real do modelo. Depois que o comando terminar com sucesso, confirme a transição na ficha com "Confirm switch and reindexing".