Версия 2.5.0#
19.09.26
Вышел новый релиз Sherpa AI Server: Версия 2.5.0.
1. Изменения на экране Документы#
На экране Документы появились поиск, теги, метки и несколько новых видов отображения документов.
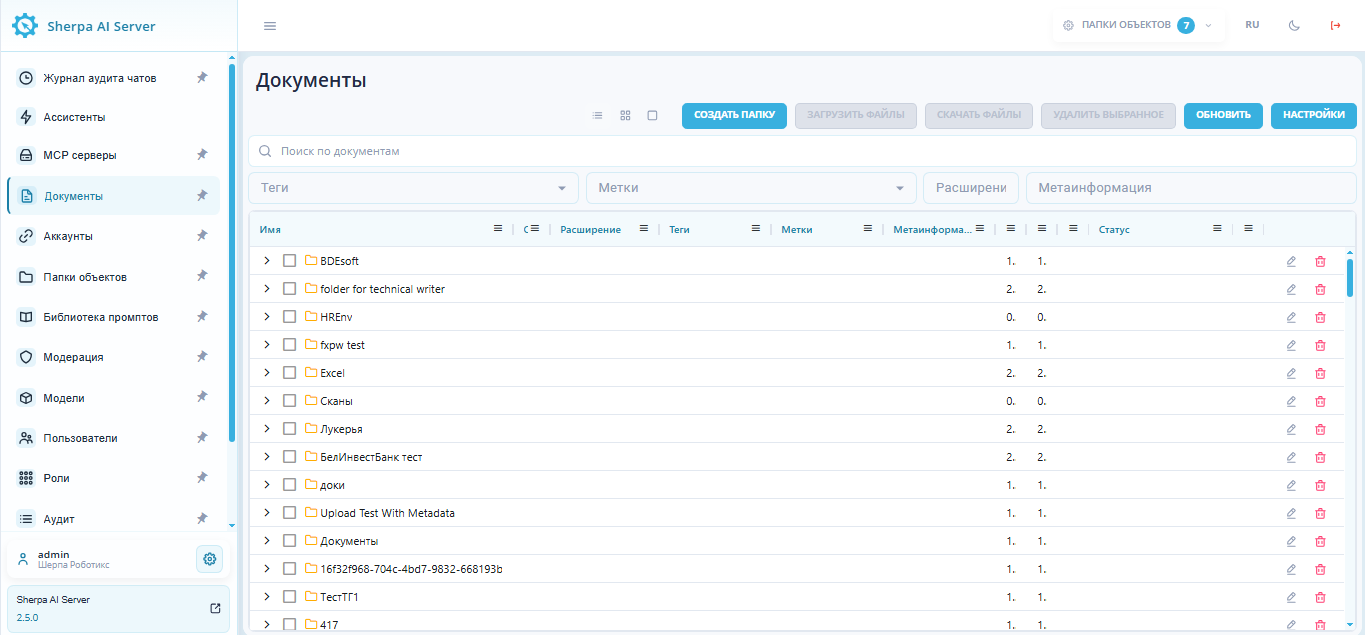
"Поиск по документам" стал точнее: теперь он находит документы по названию, описанию, расширению, папке и содержимому файла. Система учитывает не только точные совпадения, но и близкие по смыслу фрагменты текста. Найденный фрагмент подсвечивается в предпросмотре документа.
.png)
Для документов добавлены теги, метки, метаинформация и расширение. Их можно указать в карточке файла, вывести в таблице и использовать для поиска.
.png)
Появились три режима отображения экрана Документы:
- "Таблица",
.png)
- "Плитки",

- "Крупные плитки".
.png)
Также на экране Чат источник в ответе Ассистента теперь ведет к нужному документу и подсвечивает найденный фрагмент. Так проще проверить, откуда взята информация, и быстро перейти к исходному файлу.
2. Новая вкладка "Индексация"#
При на нажатии на кнопку "Настройки" на экране Документы теперь можно перейти на вкладку "Индексация". Здесь можно выбрать модель индексации, настроить размер чанка, перекрытие чанков и размерность эмбеддинга.
.png)
Если изменить модель, появится предупреждение, что после сохранения нужно запустить действие "Удалить все векторы и переиндексировать".
Индексация теперь использует модель, выбранную для Аккаунта. Для таблиц .xlsx в индекс сохраняются название листа и идентификатор подтаблицы, а старые файлы Excel .xls теперь безопасно индексируются, в том числе при загрузке из Чата.
При удалении файла из Sherpa AI Server система очищает связанные текстовые фрагменты и векторы, поэтому поиск больше не возвращает удаленные данные.
Это дает администратору больше контроля над качеством поиска по документам и снижает риск устаревших результатов после удаления или переиндексации файлов.
3. Изменения на экране Модели#
На экране Модели у каждой Модели теперь можно указать тип модели и назначения.
.png)
Модель можно назначить стандартной для отдельных задач: "Чат", "OCR / Vision", "Индексация", "Реранкер" и "Транскрибация".
.png)
В таблице эти настройки отображаются в колонке "Назначения".
Для Модели также появились "Параметры генерации (sampling)": можно выбрать готовый пресет или раскрыть расширенные параметры и настроить значения вручную.
.png)
Имя Модели теперь может содержать только латинские буквы, цифры, точки и дефисы.
Если назначенная Модель недоступна, Sherpa AI Server продолжает работу через резервный вариант из конфигурации окружения. В журнал Docker записывается причина переключения, адрес и код ответа, но без секретных данных.
Новый Чат без явно выбранной Модели теперь использует текущую текстовую Модель Аккаунта по умолчанию.
Это упрощает настройку Моделей под разные задачи и делает поведение Чата понятнее, если выбранный Экземпляр модели временно недоступен.
4. Изменения на экране MCP-серверы#
На экране MCP серверы при создании записи появилась кнопка "Выбрать из каталога".
.png)
В каталог добавлены 6 проверенных удаленных MCP-серверов и 50 стандартных шаблонов для самостоятельного развертывания.
Во всплывающем окне "Каталог MCP-серверов" теперь можно найти нужную запись и заполнить форму создания. Для шаблона сервер нужно развернуть самостоятельно и вставить его адрес.
.png)
В карточке создания/режактирования MCP-сервера теперь можно получить список доступных инструментов и выбрать, какие из них подключить. Для этого нужно заполнить данные сервера и нажать на кнопку "Получить список tools". После загрузки появится блок "Доступные инструменты" с кнопками "Подключить", "Отключить", "Подключить все" и "Отключить все". Языковая модель будет видеть только подключенные инструменты и не вызывает отключенные.
.png)
Форма создания MCP-сервера больше не отправляет повторный запрос, пока сохранение не завершилось. Благодаря этому при добавлении сервера из каталога больше не создаются дубли.
5. Поиск чатов и обновление навигации#
На экране Чат в боковом меню появился поиск диалогов по названию. Поиск учитывает область доступа Пользователя и подгружает результаты постранично.
.png)
Поле поиска выровнено по ширине с переключателем "Общие" / "Личные".
После входа боковое меню всегда открывается на основном слое с Чатами. Открытый слой навигации больше не сохраняется между сессиями, при этом закрепленные разделы остаются доступными.
6. Изменения на экране История чатов#
Экран История чатов переименован в Журнал аудита чатов. В журнале отображаются Чаты всех Пользователей Аккаунта.
.png)
Доступ к просмотру регулируется правом Роли: Журнал аудита чатов → Чтение.
В таблице журнала вложения теперь отображаются в колонке "Сообщение". Чтобы скачать вложение необходимо нажать на имя файла. Кнопка просмотра сообщения закреплена справа, а в карточке сообщения появился список вложений со скачиванием.
При экспорте журнала в CSV и XLSX добавлена колонка attachments ("Вложения"). В ней выводится стабильный список имен и идентификаторов прикрепленных файлов. Колонка действий больше не закрепляется справа и не нарушает раскладку таблицы.
7. Изменения на экране Ассистенты#
На экране Ассистенты обновлен вид карточек. Строки в карточках стали фиксированными, кнопка закрепления теперь находится сверху, а закреплённые Ассистенты отображаются первыми.
.png)
Добавлены поиск, сортировка и постепенная подгрузка Ассистентов через API. На экранах шириной до 1200 px сетка автоматически переключается с трех колонок на две.
В карточке Ассистента появились подсказки на русском и английском для температуры, системного сообщения, реранкера, источника ответа, модератора, MCP и API-токена.
В форме Ассистента теперь корректно изменяется и очищается поле "Папки объектов".
Это упрощает выбор Ассистента и помогает администратору понять назначение каждого поля без отдельной документации.
8. Изменения на экране Роли#
На экране Роли в карточке создания/редактирования Роли обязательные права меню теперь отделены от прав, которые нужны только для полного функционала.
.png)
Добавлены:
- подсказка "Минимум для входа",
.png)
- примеры Ролей для Чата.
.png)
Они помогают понять, какие права обязательно нужны Пользователю, чтобы войти в Sherpa AI Server.
Если у Пользователя нет ни одного обязательного права на чтение, вход не выполняется. Под полями формы показывается повторяемое уведомление без технических ошибок. Если сессия истекла, Пользователь возвращается на форму входа, где отображается одно сохраненное уведомление.
Это снижает риск создать Роль, с которой Пользователь не сможет войти, и делает сообщения о правах и сессии понятнее.
9. Файл для настройки видимости меню по Ролям#
Администратор теперь может скрывать пункты меню, недоступные Пользователю по ролевой модели. Настройка задается в файле внешнего вида клиента branding.json.
Этот файл поставляется вместе с Sherpa AI Server и отвечает за название приложения, логотип, цвета и отдельные элементы интерфейса. По умолчанию поведение не изменилось: недоступные пункты меню остаются видимыми, но неактивными.
Это помогает сделать интерфейс проще для Ролей с ограниченным набором прав.
10. Улучшения интерпретатора кода#
Лимит загрузки одного файла в Интерпретатор кода увеличен до 100 МиБ. Если файл отклонен из-за размера или неподдерживаемого типа, он больше не остается в папке диалога.
Для интеграций добавлен отдельный метод запуска Python в песочнице диалога без обращения к языковой модели:
POST /api/v1/threads/{thread_guid}/interpreter/execute
Администратор теперь может задать лимит ошибок Python-интерпретатора в режиме Агента через переменную окружения. Если значение не указано, используется безопасное значение по умолчанию.
Это позволяет обрабатывать более крупные файлы и вызывать Интерпретатор кода из внешних систем без лишнего запроса к Модели.
11. Изменения на экране Чат#
На экране Чат сохраненные ответы Ассистента и сообщения Пользователя больше не обрезаются, если в ответе остался незакрытый служебный блок размышлений. Пока ответ формируется, незавершенные размышления остаются скрытыми.
.png)
Если файл не загрузился из-за размера или неподдерживаемого типа, теперь показывается ошибка от API, а запрос к Модели не запускается. Крестик закрывает уведомление об ошибке, а клик по тексту уведомления копирует полный текст и показывает сообщение: "Скопировано".
Документы, которые Ассистент получил через MCP-инструменты, теперь сохраняются в шагах Агента как скачиваемые вложения. Их содержимое не передается в контекст Модели.
В режиме Агента перед ответом по нескольким документам Ассистент проверяет каждый файл с помощью смыслового и полнотекстового поиска. Если найдена только часть нужных фрагментов, он сообщает об этом.
12. Изменения на экране Модерация#
На экране Модерация колонка "Активно" стала уже.
.png)
Переключатель  теперь записывает значения
0 и 1 без лишнего идентификатора Аккаунта. В карточках для узкого экрана появился тот же переключатель вместо текста "1" и "0".
Это упрощает включение и выключение правил модерации на компьютерах и мобильных устройствах.
13. Надежная установка и обновление сервера#
В сценариях установки и обновления версия теперь фиксируется по архиву клиентских файлов. Появилось частичное обновление без смешивания архивов разных версий. Перед остановкой проверяются контрольные суммы SHA-256, манифест Docker и свободное место. Обновление сохраняет значения файла .env клиента, атомарно добавляет новые ключи и выставляет APP_VERSION из клиентских файлов целевой версии. Профили Compose сохраняются; после обновления проверяются миграции, состояние служб, теги и запущенные образы. Граница отката указана явно.
При свежей установке заводской пароль PostgreSQL теперь заменяется случайным и не выводится в журнал. Для профиля с запуском на процессоре llama.cpp получает совместимый файл модели, а установка и обновление дожидаются готовности службы.
В документацию добавлено воспроизводимое руководство по тестированию производительности vLLM и подбору параметров LLM_* под целевую нагрузку и графический процессор.
14. Сборка образов и подсчет токенов#
Исправлена сборка Whisper без доступа к внешним репозиториям пакетов: используется готовый базовый Docker-образ с зависимостями. Для индексации презентаций .ppt и .pptx в изолированных установках в образ службы индексации включены необходимые языковые данные.
Точный подсчет токенов восстановлен для экземпляров vLLM с подпутем v1; если метод /tokenize недоступен, переход на приблизительную оценку записывается в журнал.
Это снижает зависимость сборки от внешней сети и делает индексацию презентаций и подсчет токенов стабильнее в изолированных установках.